在机器视觉中,一个基本要求是将不同图像中的颜色分量分离。 例如,这可以是 RGB 到其分量的分离,也可以是 HSL 或 XYZ 等的分离。 以下展示了一些颜色分离的示例。 所有示例均使用 RGB 面阵相机作为输入。 当然,这些示例也完全适用于线阵相机。 此外,通常需要进行前置的 Bayer 去马赛克或色彩空间转换,这些都可以轻松添加到示例中。
这些示例假设颜色分离是用于主机 PC 上的后处理。 因此,这些示例侧重于颜色分离的 DMA 传输。 如果您需要在 FPGA 中对颜色分离的数据进行处理,这些示例同样可以满足您的需求。
展示了几个示例。 所有示例的结果都是相同的。 然而,它们的实现方式完全不同,且各有优缺点。 您需要选择最符合您需求的示例。 下表列出了所有示例及其部分 Property。
| 示例名称 | 延迟 | DRAM | Block RAM 数量 | DMA 输出 |
|---|---|---|---|---|
| 三个 DMA | 无额外延迟 | 1 个 DRAM 缓冲区 | 低电平 | 3 个 DMA。每个颜色分量一个。 |
| 带有 3 个缓冲区的串行模式 | 延迟已减小至理论最小值。 | 3 个 DRAM 缓冲区 | 低电平 | 1 个 DMA。串行颜色分量输出。 |
| 带有 MultiROI 缓冲区的串行模式 | 1 帧延迟和带宽限制。 | 1 个 DRAM 缓冲区 | 正常 | 1 个 DMA。串行颜色分量输出。 |
| 带有预排序 MultiROI 缓冲区的串行模式 | 1 帧延迟 | 1 个 DRAM 缓冲区 | 高电平 | 1 个 DMA。串行颜色分量输出。 |
| 带有高级缓冲区用法的串行模式 | 1 帧延迟 | 1 个 DRAM 缓冲区 | 低电平 | 1 个 DMA。串行颜色分量输出。 |
表 20. 颜色分离示例概述
上一表中显示的 Property 的完整说明以及不同方法的完整说明将在接下来的章节中概述。
| 简短说明 | |
|---|---|
|
文件: \examples\Processing\Color\ColorPlaneSeparation\ColorPlaneSeparation_Option1_ThreeDMA.va |
 |
|
默认平台: mE5-MA-VCL |
|
|
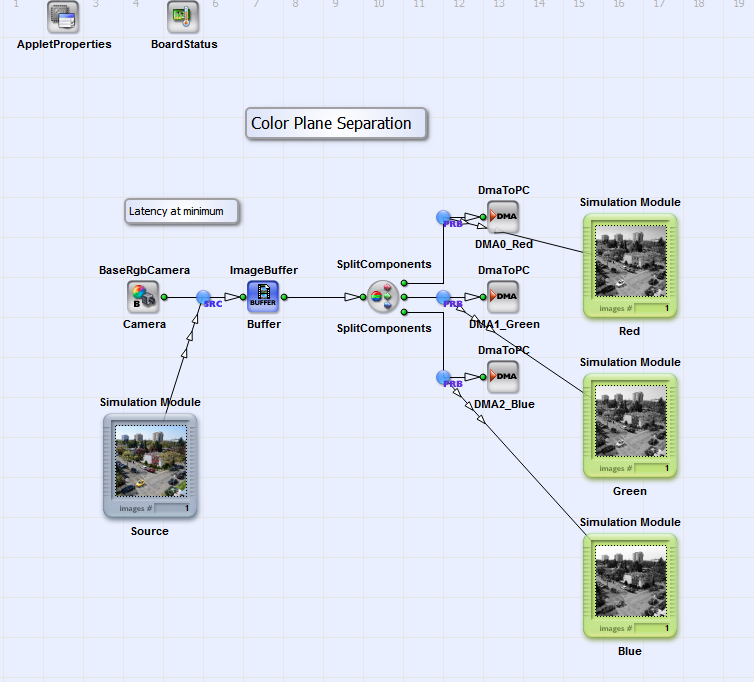
简要说明 RGB 色彩平面分离示例。 这些分量被拆分为三个 DMA 输出通道。 |
|
这个示例非常简单。 输入的 RGB 图像会被缓冲,随后色彩平面被拆分为三个输出链路。 这三个链路使用三个 DmaToPC 算子传输到 PC。 此方案的一个优点是延迟极低。 图像不会在采集卡中被缓冲。 如果主机 PC 足够快,ImageBuffer 算子只会将图像延迟一行。 不会产生额外的延迟。 另一个优点是只需要一个 DRAM 算子。
该实现的一个缺点是需要三个 DMA 输出算子。 这些算子会消耗采集卡的大量 FPGA 逻辑资源。 如果您不需要如此低的延迟,您应该考虑后续章节中介绍的解决方案之一。
| 简短说明 | |
|---|---|
|
文件: \examples\Processing\Color\ColorPlaneSeparation\ColorPlaneSeparation_Option2_ThreeBuffersOneDMA.va |
 |
|
默认平台: mE5-MA-VCL |
|
|
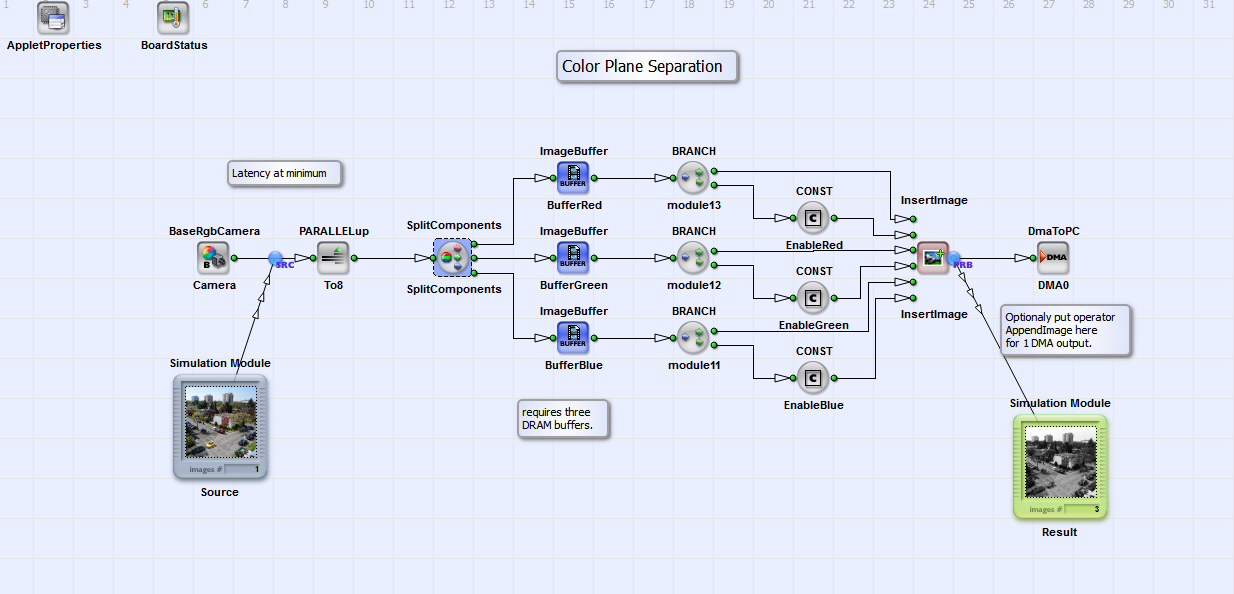
简要说明 RGB 色彩通道分离示例。 将各个分量拆分并缓冲在三个采集卡缓冲区中。 随后,通过一个 DMA 通道依次输出这些色彩通道。 |
|
在该 RGB 色彩通道分离解决方案中,色彩通道通过 DMA 通道按顺序输出。 具体方法是将 RGB 输入拆分为各个分量,并分别缓存在三个 ImageBuffer 模块中。 使用 InsertImage 算子,从 ImageBuffer 中依次读取色彩通道。
在此示例中,在将数据写入 ImageBuffer 之前增加 Parallelism 非常重要。 否则,将在 InsertImage 模块之后产生瓶颈。
这种方法的优点是仅需要一个 DMA 通道,从而减少了所需的资源。 此外,延迟达到了顺序输出的理论最小值。 红色通道的 DMA 传输会立即开始,毫无延迟。 该方案的一个缺点是需要三个采集卡 Memory 算子。 由于这些算子数量有限,因此该方案仅在不需要更多此类缓冲区时才适用。
| 简短说明 | |
|---|---|
|
文件: \examples\Processing\Color\ColorPlaneSeparation\ColorPlaneSeparation_Option3_SequentialMultiROI.va |
 |
|
默认平台: mE5-MA-VCL |
|
|
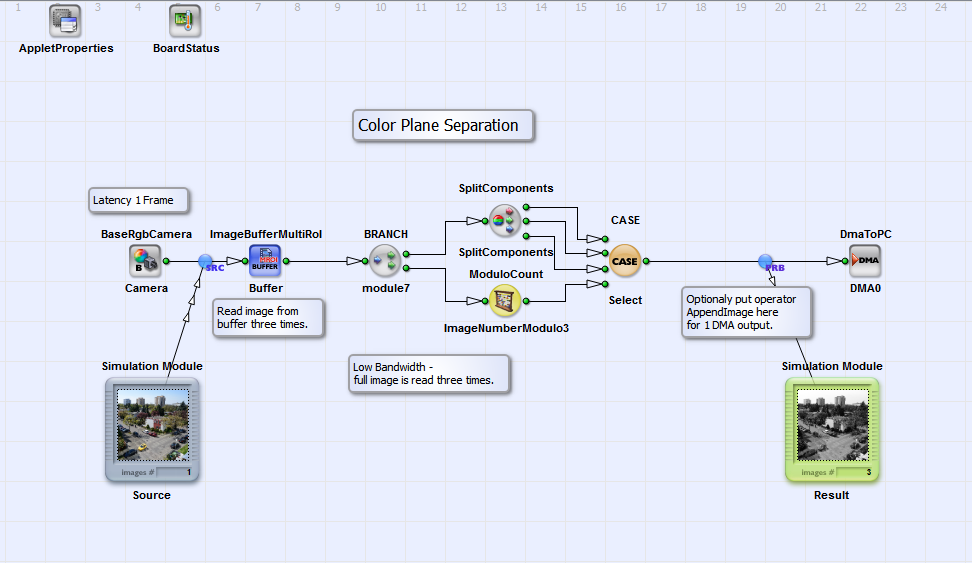
简要说明 RGB 色彩通道分离示例。 对三个 RGB 色彩通道执行顺序 DMA 输出。 该顺序由 ImageBufferMultiRoI 生成。 此方案效果不佳,因为它限制了带宽。 有关优化后的解决方案,请参见下一个示例。 |
|
该解决方案是介于上一个示例和下一个示例之间的过渡步骤。 由于带宽限制,不建议实施此解决方案。 不过,它以一种简单的方式解释了如何在仅需要一个采集卡 RAM 的情况下获得与上一个示例相同的输出。 为了将图像序列化,我们使用了 ImageBufferMultiRoI 算子。 在该算子中,我们简单地读取同一图像三次。 然后,我们为第一幅图像选择红色分量,为第二幅图像选择绿色分量,为第三幅图像选择蓝色分量。 这可以轻松通过 ModuloCount 和 CASE 算子完成。 对 ModuloCount 进行参数化,以对帧数进行模 3 计数,即 {0, 1, 2, 0, 1, 2, ...}。
如前所述,此方案并非最佳方案,因为它降低了带宽。 原因是我们读取了相同的输入图像三次,但只使用了三个分量中的一个。 因此,在每个读取周期中,我们都丢弃了三分之二的数据。 下一个示例将展示一个克服此限制的类似解决方案。
| 简短说明 | |
|---|---|
|
文件: \examples\Processing\Color\ColorPlaneSeparation\ColorPlaneSeparation_Option4_SequentialPreSortMultiROI.va |
 |
|
默认平台: mE5-MA-VCL |
|
|
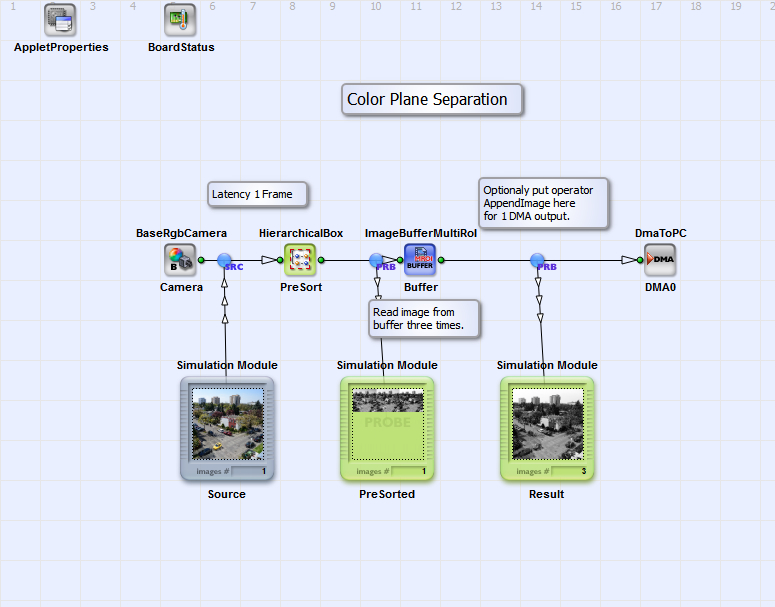
简要说明 RGB 色彩通道分离示例。 对三个 RGB 色彩通道执行顺序 DMA 输出。 该顺序由 ImageBufferMultiRoI 生成。 额外的预排序优化了带宽并解决了前一个示例中提出的问题。 |
|
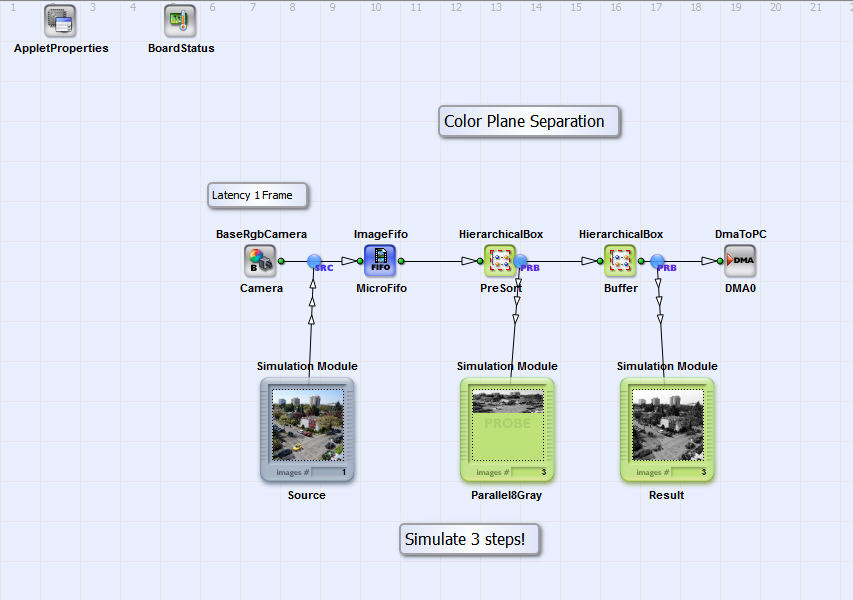
此示例类似于前一个示例。 相比之下,在这种情况下我们没有带宽限制。 其思路是相同的。 通过使用 ImageBufferMultiRoI 算子,我们将三个色彩分量序列化。 与前一个示例不同,我们不在缓冲区之后分离颜色。 而是在将颜色写入缓冲区之前进行分离。 这在 HierarchicalBox PreSort 中完成,其内容如下图所示。
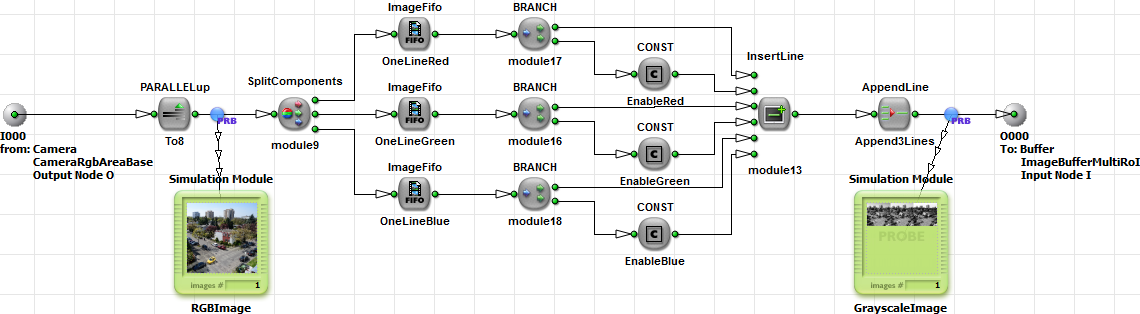
这种方法的思路是在将色彩分量写入缓冲区之前将其分离。 这对每一行图像都适用。 因此,我们将色彩分量拆分为三个链接。 这些生成的灰度链接现在包含输入图像的图像行。 接下来,对这些行进行多路复用和拼接。 其结果是我们在一个大图像中拥有三个灰度图像。 红色分量在左侧,绿色在中间,蓝色在右侧。 请查看下一图中的仿真结果以理解该实现。
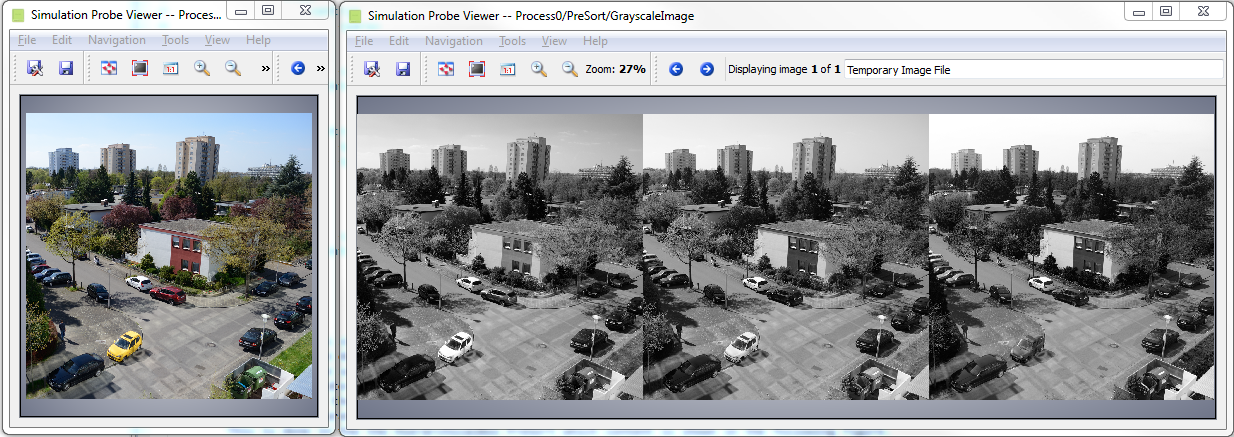
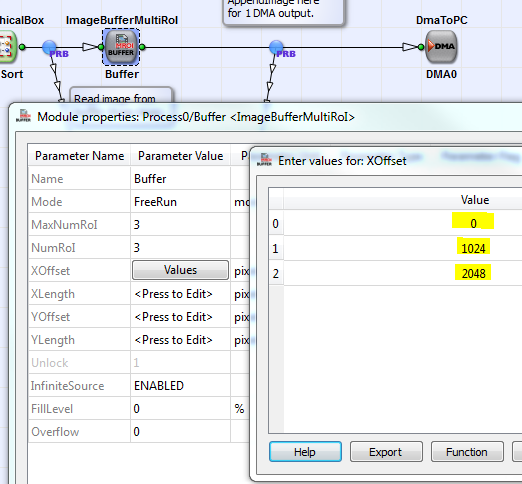
在 ImageBufferMultiRoI 中,我们现在必须首先读取左侧部分。 然后是中间部分,最后是右侧部分。 因此,我们需要为每个 ROI 设置不同的 XOffset,如下所示。
在使用时,切记在分离分量之前增加 Parallelism,如示例所示。 这是为了避免在 InsertLine 模块之后产生瓶颈。 由于我们传输的是 8 位灰度图像,不再是 24 位 RGB 图像,因此我们需要至少比输入高三倍的 Parallelism。
此解决方案确实只需要一个 DRAM 算子,并且不会限制带宽。 这是一个优化的解决方案。 但是,需要一些块 RAM 来缓冲 FIFO 中分离出的分量行。 对于小图像,这应该不会成问题。 但是,如果您有很大的图像宽度(例如每行 16384 个像素),则需要大量的块 RAM。 最后一个缺点可以通过下一个示例来解决。
| 简短说明 | |
|---|---|
|
文件: \examples\Processing\Color\ColorPlaneSeparation\ColorPlaneSeparation_Option5_SequentialAdvanced.va |
 |
|
默认平台: mE5-MA-VCL |
|
|
简要说明 色彩通道分离示例。 RGB 输入被拆分为其分量,并通过一个 DMA 通道顺序输出。 拆分通过并行收集相同分量并使用 FrameBufferRandomRead 进行读取来执行。 |
|
这是 VisualApplets 中用于色彩通道分离的高级示例。 它侧重于最小的资源使用和最大的带宽。 前一个示例使用预排序来分离色彩分量,以便我们可以从缓冲区中单独读取它们。 但是,预排序中的 FIFO 需要一些块 RAM。 在此方法中,我们也使用了预排序。 与此不同的是,在切换到下一个分量之前,我们仅收集每个色彩分量的 8 个连续像素。 在上一个示例中,我们在切换到下一行之前收集了一个分量的完整行。 这种修改导致我们不再需要 FIFO。 然而,在这种情况下无法使用 ImageBufferMultiRoI。 相反,我们必须使用 FrameBufferRandomRead。
预先排序很简单。 首先,我们将 Parallelism 增加到 8。 接下来,对组件进行拆分。 这将产生三个并行度均为 8 的链接。 现在,MergeParallel 将把组件的 8 个像素按顺序排列。 因此,我们将获得一个序列:R0 到 R7、G0 到 G7、B0 到 B7、R8 到 R15、G8 到 G15、B8 到 B15,依此类推。
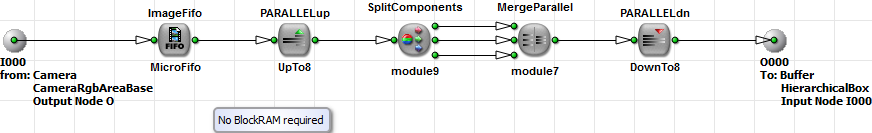
由于 PARALLELdn 从 16 变为 8,因此需要在输入端设置 FIFO。 此 FIFO 仅用于避免 DRC 级别 2 错误。 实际上,它不需要缓冲数据,因此我们将其大小设为仅 2 个像素的极小值。
对像素进行预先排序后,它们将被缓冲在 FrameBufferRandomRead 算子中。 该算子具有读取行和列地址输入,并允许随机读取数据。
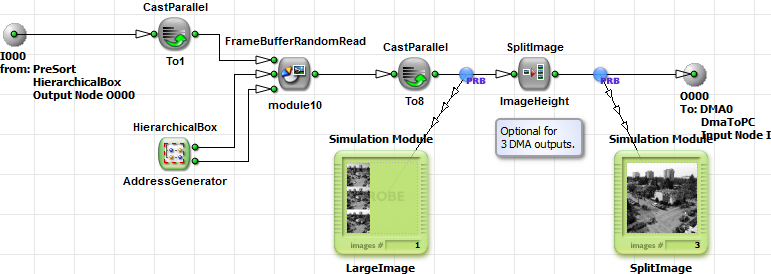
该算子只能在并行度为 1 的情况下使用。 因此,我们使用 CastParallel 将并行度 8、每像素 8 位转换为并行度 1、每像素 64 位。 这就是我们在上一步中收集 8 个连续像素的原因。
为了分离颜色分量,我们必须将地址增加 2 以跳过不需要的颜色。 对于红色分量,读取地址将为:RColA(0) = 0、RColA(1) = 2、RColA(2) = 5,依此类推。 对于绿色分量,读取地址将为:RColA(0) = 1、RColA(1) = 3、RColA(2) = 6,依此类推。 分层框 AdressGenerator 会生成这些读取地址。 CreateBlankImage 算子定义了所需的图像尺寸。 由于我们之前使用了从 8 到 1 的 CastParallel,因此我们必须使用除以 8 的图像宽度。
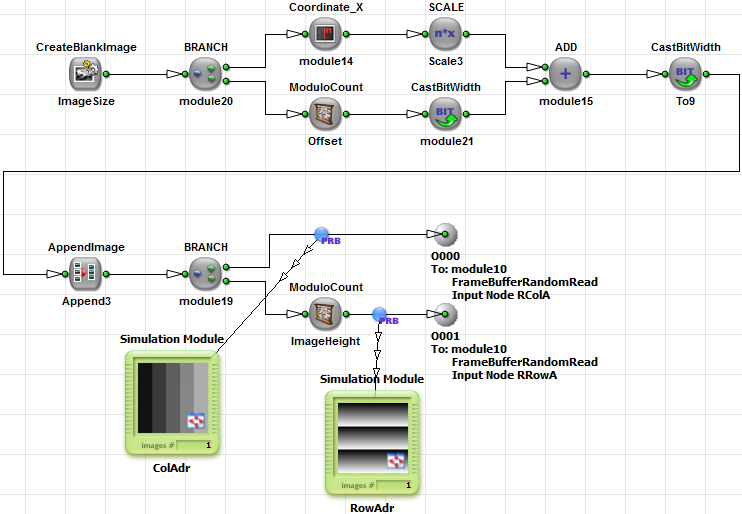
列地址是通过对 Coordinate_X 输出应用 3 的 Scaling 简单生成的。 根据当前分量,我们在值中添加 0、1 或 2 作为偏移量。
通过使用 AppendImage,将三个地址图像合并为一个更大的图像。 行地址只需通过 0 到图像高度之间的 Counter 来生成。 在此情况下,我们为此任务使用一个 ModuloCount 算子。 现在,这些地址可以输入到 FrameBufferRandomRead 算子中。 切记在 CreateBlankImage 输出端使用并行度 2,以最大化 FrameBufferRandomRead 的性能。
在缓冲区之后,我们获得了一个大型图像,其中前几行包含红色图像,接着包含绿色图像,最后包含蓝色图像。 为了将此大型图像分割为三个独立的 DMA 输出,我们使用 SplitImage 并设置图像高度。
理解该实现的最简单方法是逐步查看中间结果。 请注意,您需要为一个结果图像模拟三个步骤。 这是因为算子 CreateBlankImage 必须生成 3 个图像。
此解决方案经过了资源优化,因为只需要少量的块 RAM 资源。 此外,FPGA 逻辑资源也得到了高效利用。 地址生成仅需少量资源。
 上一页

